2026-09-18 · AI 工具链
当 AI 够用就够了:一篇审计复盘给我的工具链启发
大家都盯着「AI 自动找 bug」,但 Trail of Bits 的复盘里更值钱的是上一环——在审代码之前,agent 已经能帮你把审查用的工具链和形式化模型先造出来。这篇顺着它,理了两条杠杆和一个能马上动手的起点。
最近半年,「AI 自动找 bug」是安全圈最热闹的故事。但 Trail of Bits 一篇 Miden 审计复盘,把我带到了这个故事的上一环——在 AI 开始审代码之前,它先帮你把审代码用的工具造了出来。
它讲的安全审计离我们做漫剧、做 AI 工具挺远,但那条思路值得抄,尤其是「好用的 AI 阶段,杠杆到底在哪」这件事。下面是我顺着它,理给自己听的几层。
大家盯着的那层,其实不是重点
最近半年,安全公司发了不少文章,主题都是同一个:把 agent 接到代码库上,自动找出几十个 bug。Trail of Bits 自己也是其中之一,演示里一大串 CVE、空指针、整数溢出被逐个点名。
但这只是 AI 在审计里的一种用法——代码审查。它的那篇复盘想换一个角度讲:在那之前,agent 已经能帮你把审查要用的工具先造出来,从而让后面的审查更深、更稳。代码审查是结果,造工具才是前置的、更值钱的那一步。
第一层:用 AI 造你自己的工具链
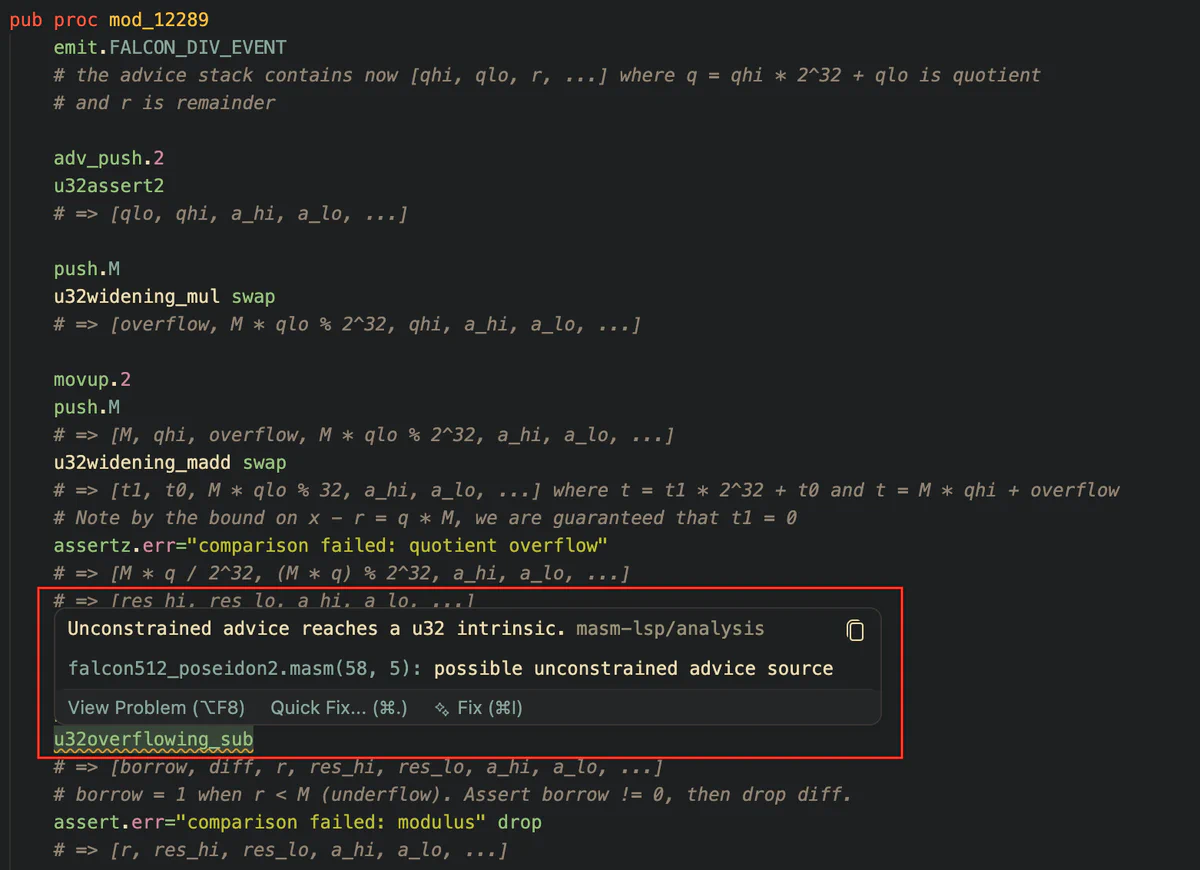
他们用 Claude 和 Codex 搭了一个通用的「抽象解释(abstract interpretation)引擎」,再在它上面实现了一系列具体的分析 pass。过程中让 agent 在「写代码」和「审代码」之间来回切——写一段、审一段、改、再写。
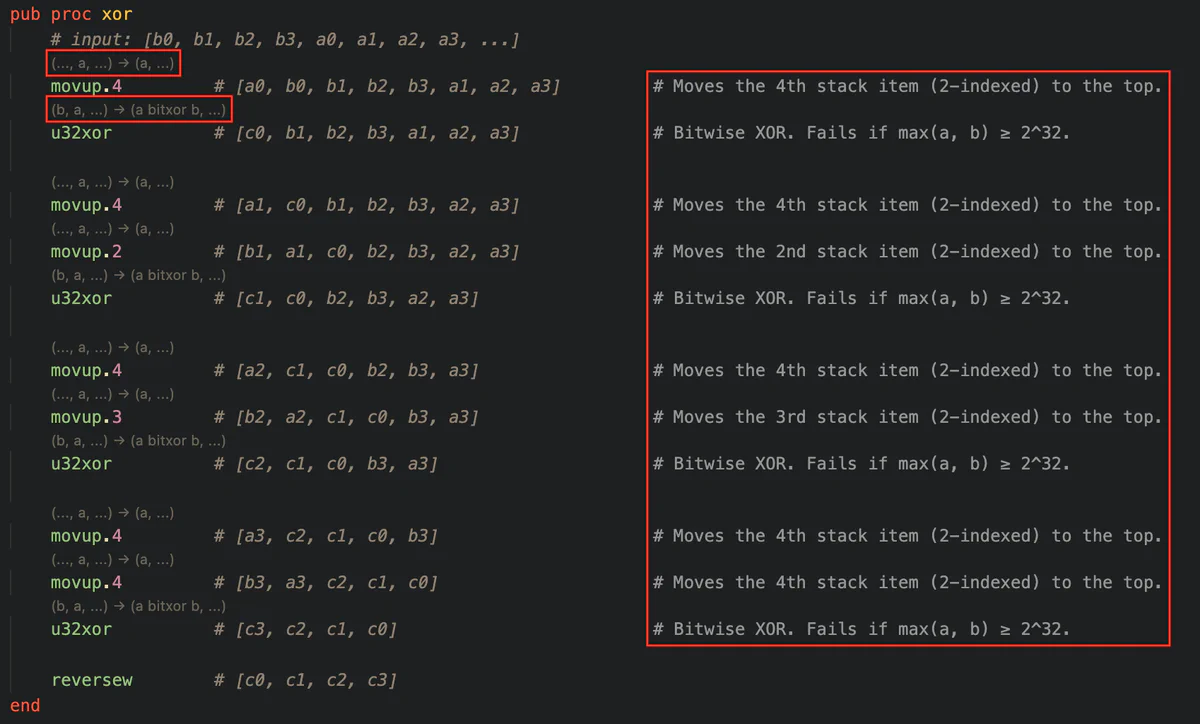
更关键的一步:他们还给反编译器和一个新的 MASM linter 做了命令行接口,让这些新工具能直接喂给 agent 驱动的 code review 工作流。
一句话总结这一层:AI 不只是在帮你干活,它先帮你把干活的家伙事儿造齐了。 工具就位之后,agent 才真正开始反复调用它们。
第二层:如果没有 bug 怎么办
工具齐了之后,他们想了个更狠的问题——如果核心库的实现本来就是对的、根本没有 bug,能不能证明这一点?
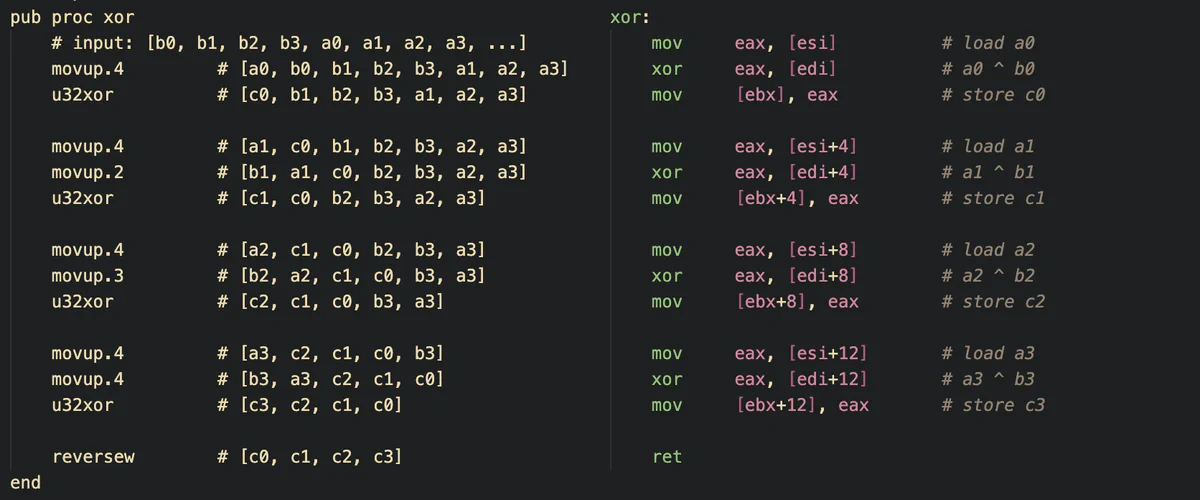
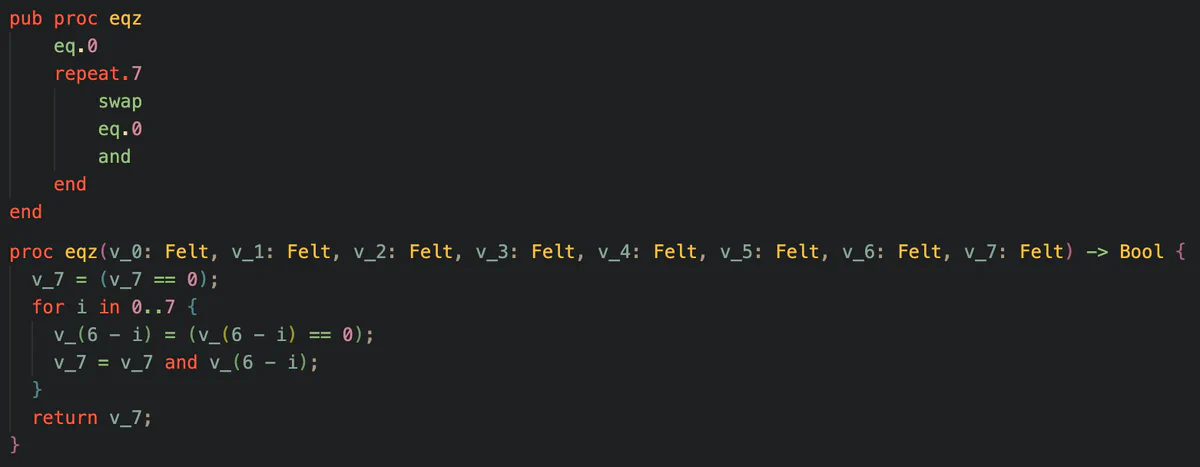
Miden VM 很适合形式化建模(指令集小、多数指令无副作用)。做法是:在 Lean 里写一个最小 Miden VM 执行器,再让 Claude 自动把 MASM 过程翻译成 Lean。然后多个 agent 并行去证明库里尽可能多的过程的正确性。
这里最妙的地方:Lean 内核负责验证生成的证明对不对,人只需要手动审「定理声明到底证对了哪个性质」。正确性性质被统一成一种很干净的形式——
若栈是[x1, x2, …, xn],执行过程 P 后,P 终止且栈变成[P(x1, …, xn)]。
把一个复杂系统的正确性,收束成「输入和输出之间的映射关系」——这一步才是把不可言说的「看起来对」变成了可机器核验的东西。
三层放在一起看
| 做法 | 人在哪 | AI 在哪 | 产出能不能留下来 |
|---|---|---|---|
| 传统审代码 | 一行行读、凭经验挑 | 几乎不参与 | 很难,经验在脑子里 |
| 第一层:造工具链 | 定方向、审工具 | 写引擎、写 pass、写接口 | 能,工具会一直陪你 |
| 第二层:形式化证明 | 只审定理声明 | 翻译 + 并行证明 | 能,证明可被内核复验 |
注意最后一列。前两层的差别,不只是「快不快」,而是产出的东西能不能在你不在的时候继续帮你干活。
为什么两年前做不到
文末给了一句大实话:纯粹是模型能力问题。当年的模型撑不起「造引擎 + 写翻译器 + 并行证明」这种复杂度——每一步单独看都行,串起来需要的上下文长度和稳定性,是这两年才长出来的。
换句话说,这条链路不是「想到了就能做」,而是刚好卡在模型能力跨过某个阈值的节点上。
我的启发:杠杆不在「执行」,在「造工具 + 可验证」
把这事从安全审计抽出来,落到我们自己的活儿上,几条是通用的:
- 别只把 AI 当一次性执行器。 真正的杠杆是「用 AI 造专属工具链」,再让 AI 反复调用这些工具。一次性的活儿干完就没了,工具留下来会一直帮你。
- 把领域动作固化成可复用的东西。 你每周都在重复的动作(压图、转格式、扫违禁词、跑分镜提示词),与其每次手搓,不如写成 skill 包——这正是墨屿现在挂的那一墙技能的思路来源。
- 能验证就验证,别只信「看起来对」。 Lean 那套对我们太重,但「让一个独立的东西复核另一个东西」这个习惯值得带进日常:比如让 agent 写完,再换一个角度让它挑刺。
一个可以马上动手的起点(以压图为例)
你不用复刻安全审计,复刻的是那个思路。挑一个你这周一定会重复做的动作,把它拆成「输入是什么、步骤有几步、每一步的判断标准是什么」,写成一个 skill。我拿墨屿实际在用的「压图」举个例子:
- 输入:一张原始 PNG/JPG(可能是用户微信发来的,也可能是出图结果)。
- 步骤:量长边 → 按目标长边等比缩 → 试几个质量档 → 选「刚好压到体积线以下」的那档。
- 判断标准:长边 1440、WebP、单图 < 150KB;压完必须肉眼无可见糊化。
- 固化:把上面这套写成 skill,以后
压缩 这张图一句话就出结果,不用每次想参数。
这一个动作,从「每次手搓 5 分钟」变成「一句话 5 秒」。攒够十个,你就有一套属于自己的工具链了。
对一个团队来说,这一点更值钱
把重复劳动固化成工具链,好处不只是「这次省点时间」——它让团队里每个人都能直接调用别人已经踩通的路子,而不用各自从头再摸一遍。「用 AI 造自己的工具链」在这里是杠杆最大的一档:它把原本要靠口头交代、反复对齐才能传下去的东西,变成了一组谁都能直接跑的 skill。
而这恰恰是「够用就够了」的 AI 真正开始替你省时间的地方:不是替你多干几件一次性的活,而是替你把干活的本事留下来的。