2026-09-19 · AI 工具链
约束 AI,别指望它自觉
提示词里写「禁止……」是软约束——说服得动,也忘得掉。看了 CloudBase 讲 WorkBuddy 后端设计的文章,最戳我的是一句:安全边界由基础设施保证,而不依赖 Agent 不出错。
前几天看了 CloudBase 团队的一篇文章,讲 WorkBuddy 5.5.6 的「一句话生成应用」背后,后端是怎么设计的。大家聊这类功能的注意力基本都在「生成」上——一句话,出来一个带数据库、带登录、直接能访问的完整应用。我却对他们怎么对待「AI 会出错」这件事更感兴趣。
先说他们做了什么
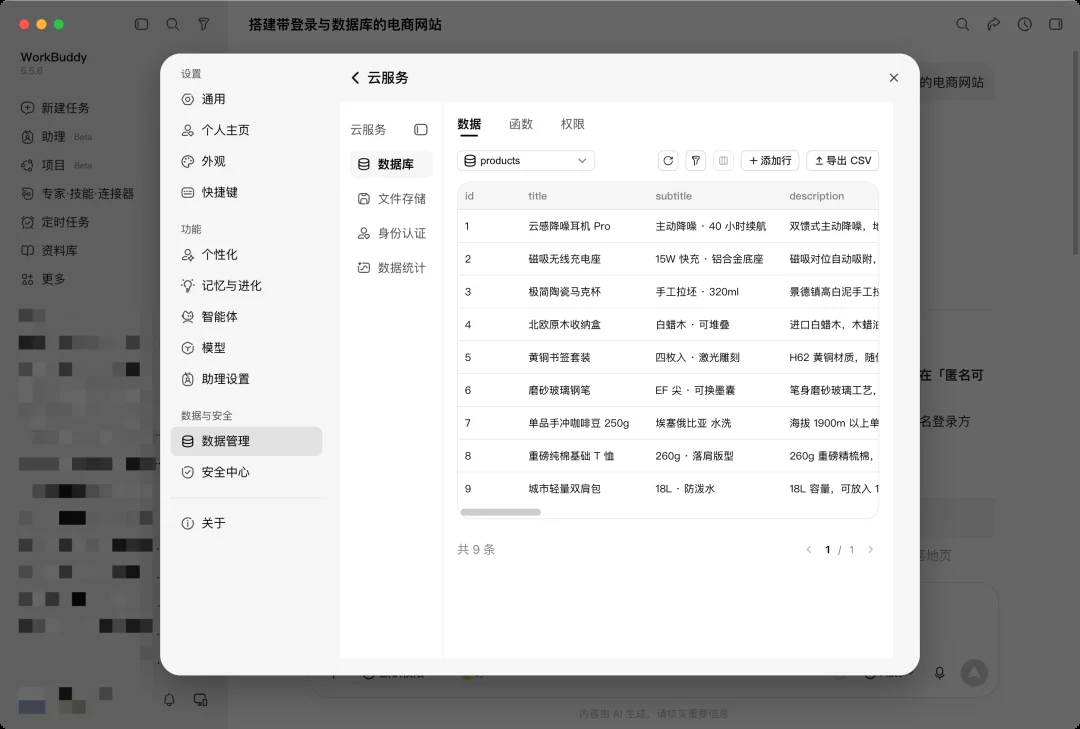
一句话生成应用,难点从来不在「生成页面」——那早就有了。难的是后面那一摊事:数据存哪、谁能访问、怎么上线。他们的做法是把这摊事整个变成基础设施:每个应用一个独立环境,PostgreSQL、登录、文件存储、连大模型调用都是现成的,Agent 通过 API 直接建表、写权限规则、部署、回滚,全程不需要人去控制台点一下。
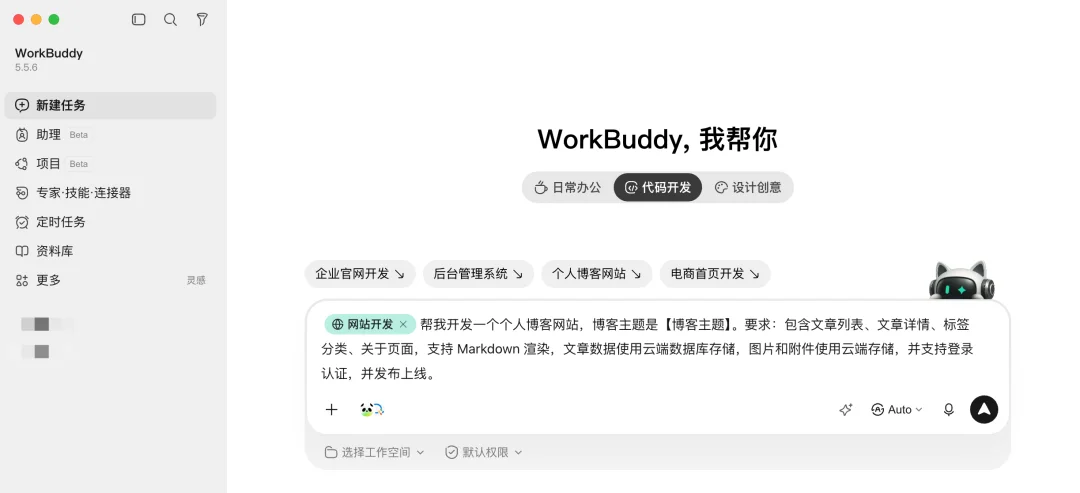
连注册登录都是托管好的,邮件验证码怎么发都不用你自己去申请 SMTP 服务。
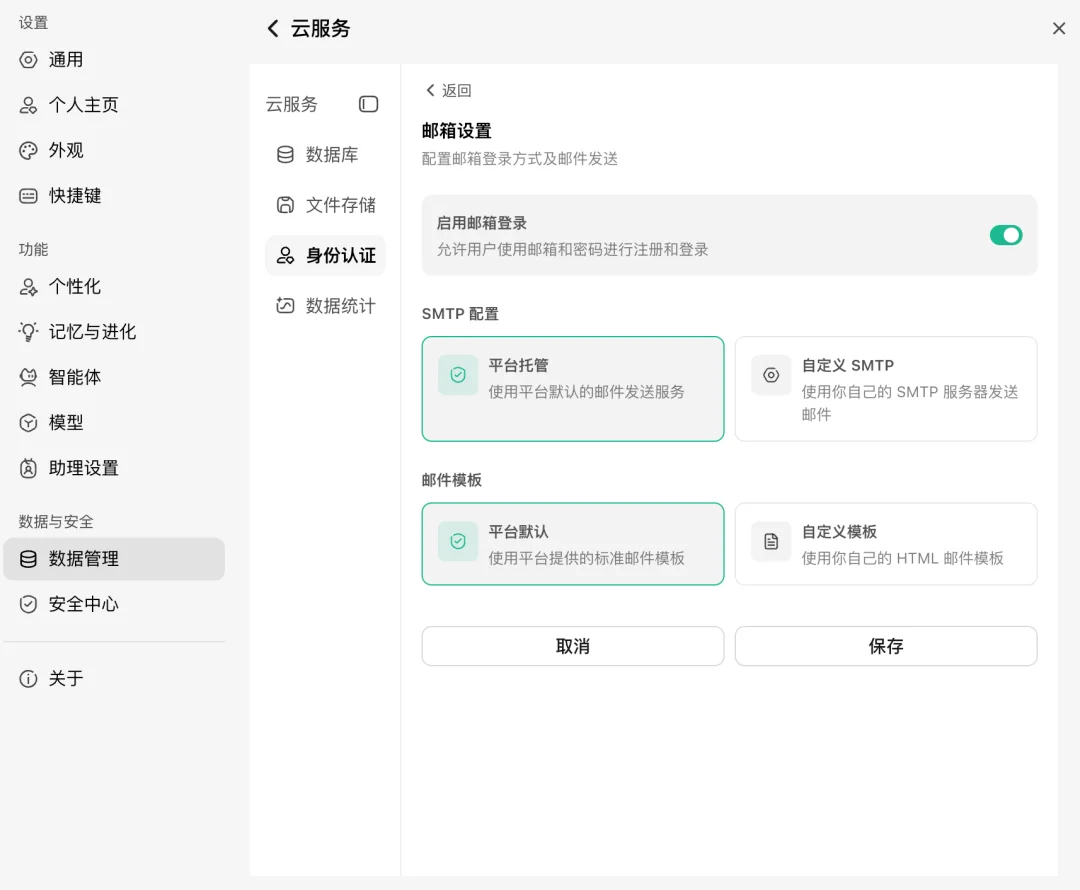
规模也是真的:文章里说,现在每天有上万个应用被各种 Agent 在 CloudBase 上创建出来,平台约三分之一的调用量来自 Agent。
大家管 AI,习惯用提示词
我们平时用 AI 干活,最常见的约束方式是往提示词里写「不要……」「禁止……」「只基于给定内容工作」。我自己也这么干,团队用的那套提示词模板里就有一节专门写硬性约束。
这类约束有个共同点:它是说给 AI 听的。它管住的是「大多数时候」,管不住「这一次」。模型状态好坏、上下文多长、你那句话怎么断句,都可能让它把这行「禁止」忘掉。提示词是软约束——说服得动,也忘得掉。
他们把边界做进了基础设施
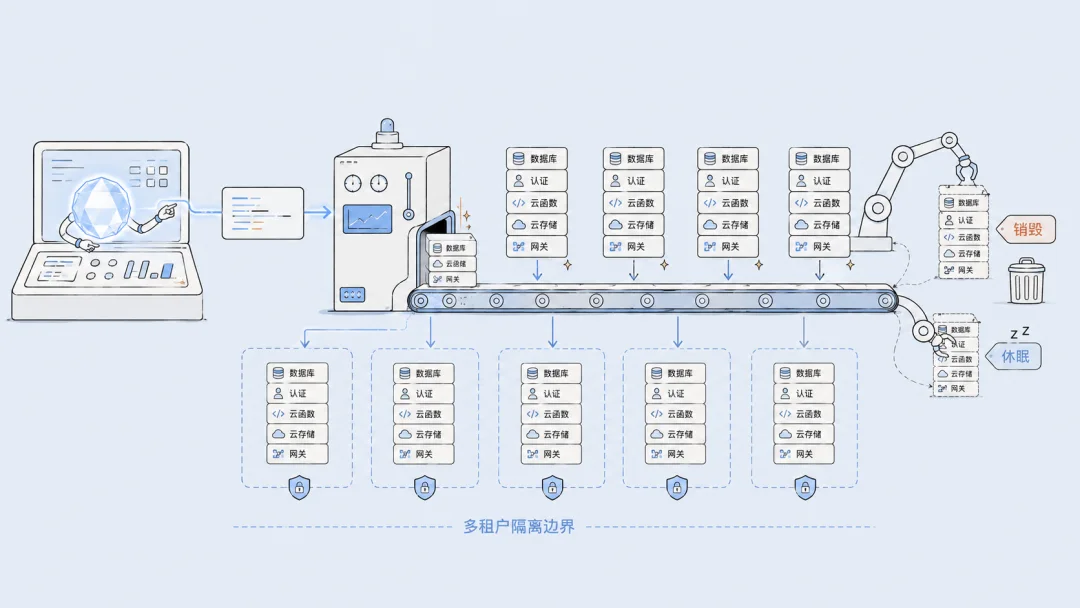
整篇文章里我觉得最值钱的是这个设计:每个环境签发独立的 API Key,Agent 拿着哪个环境的 Key,就只能操作那个环境里的资源。就算 Agent 生成了错误的指令,也越权改不到别人的环境。安全边界由基础设施层保证,而不依赖 Agent 不出错。
这句话把两个问题分开了:「会不会出错」是概率问题,「出了错波及多大」是结构问题。前者你只能想办法提高概率,后者你可以把它做成结构上不可能。
连数据权限都是同一种思路:规则用 SQL 显式写出来(RLS),Agent 可以直接读它、校验它。规则不再是「藏在某处的约定」,而是一份机器可查的声明。
软约束和硬约束
上一篇写审计复盘的文章里我说,「能验证就验证,别只信看起来对」——让一个独立的东西去复核另一个东西。这一篇其实是把同一件事又往前推了一步:复核是「出了错能发现」,边界是「出了错也无害」。
两条放在一起,差不多就是跟 AI 协作的全部底线:能验证的,别靠自觉;能做成边界的,别写成叮嘱。
落到我们自己的活儿上
把「禁止」从提示词里往外挪,几个方向是现成的:
- 输入上收窄:给它的材料只给该看的,它想自由发挥也没有原料。团队协作里这点特别实际——与其反复叮嘱「别改设定」,不如让工具只接受固定格式的输入。
- 输出上圈地:它写的东西只允许落在指定目录、指定格式,出了圈一律无效。
- 规则写成声明:能写成一份机器可查的清单(像 RLS 那样),就别写成一段叮嘱的话。
我们提示词规矩里有一条「信息不足就提问,绝不脑补」,算是这种思路的软版本;真正硬的版本,是让它想脑补的时候,根本没有可以脑补的空间。
(文中产品截图与插画来自 CloudBase 团队公众号文章《WorkBuddy × CloudBase:让 AI 负责 Coding,让 CloudBase 负责后端》,版权归原作者所有。)